Vì sao chat với AI càng lâu càng trả lời kém? Suy hao ngữ cảnh là gì và khi nào nên mở cuộc trò chuyện mới
Vì sao chat với AI càng lâu càng trả lời kém? Suy hao ngữ cảnh là gì và khi nào nên mở cuộc trò chuyện mới
Trả lời ngay:
- ⛔ AI không "mệt" như người. Nó trả lời kém dần vì mỗi lượt phải đọc lại toàn bộ cuộc trò chuyện. Ngữ cảnh càng dài và càng nhiều lượt thì độ chính xác và độ ổn định càng giảm. Hiện tượng này gọi là suy hao ngữ cảnh (context rot).
- ⚠️ Cửa sổ ngữ cảnh lớn không miễn nhiễm. Nghiên cứu trên 18 mô hình hàng đầu cho thấy hiệu năng giảm khi đầu vào dài ra, kể cả với tác vụ đơn giản. Giao việc rải rác qua nhiều lượt làm kết quả giảm trung bình 39% so với giao một lần.
- ✅ Khi thấy dấu hiệu suy hao, hãy mở cuộc trò chuyện mới, mang theo một bản bàn giao ngắn thay vì kéo dài cuộc trò chuyện cũ.
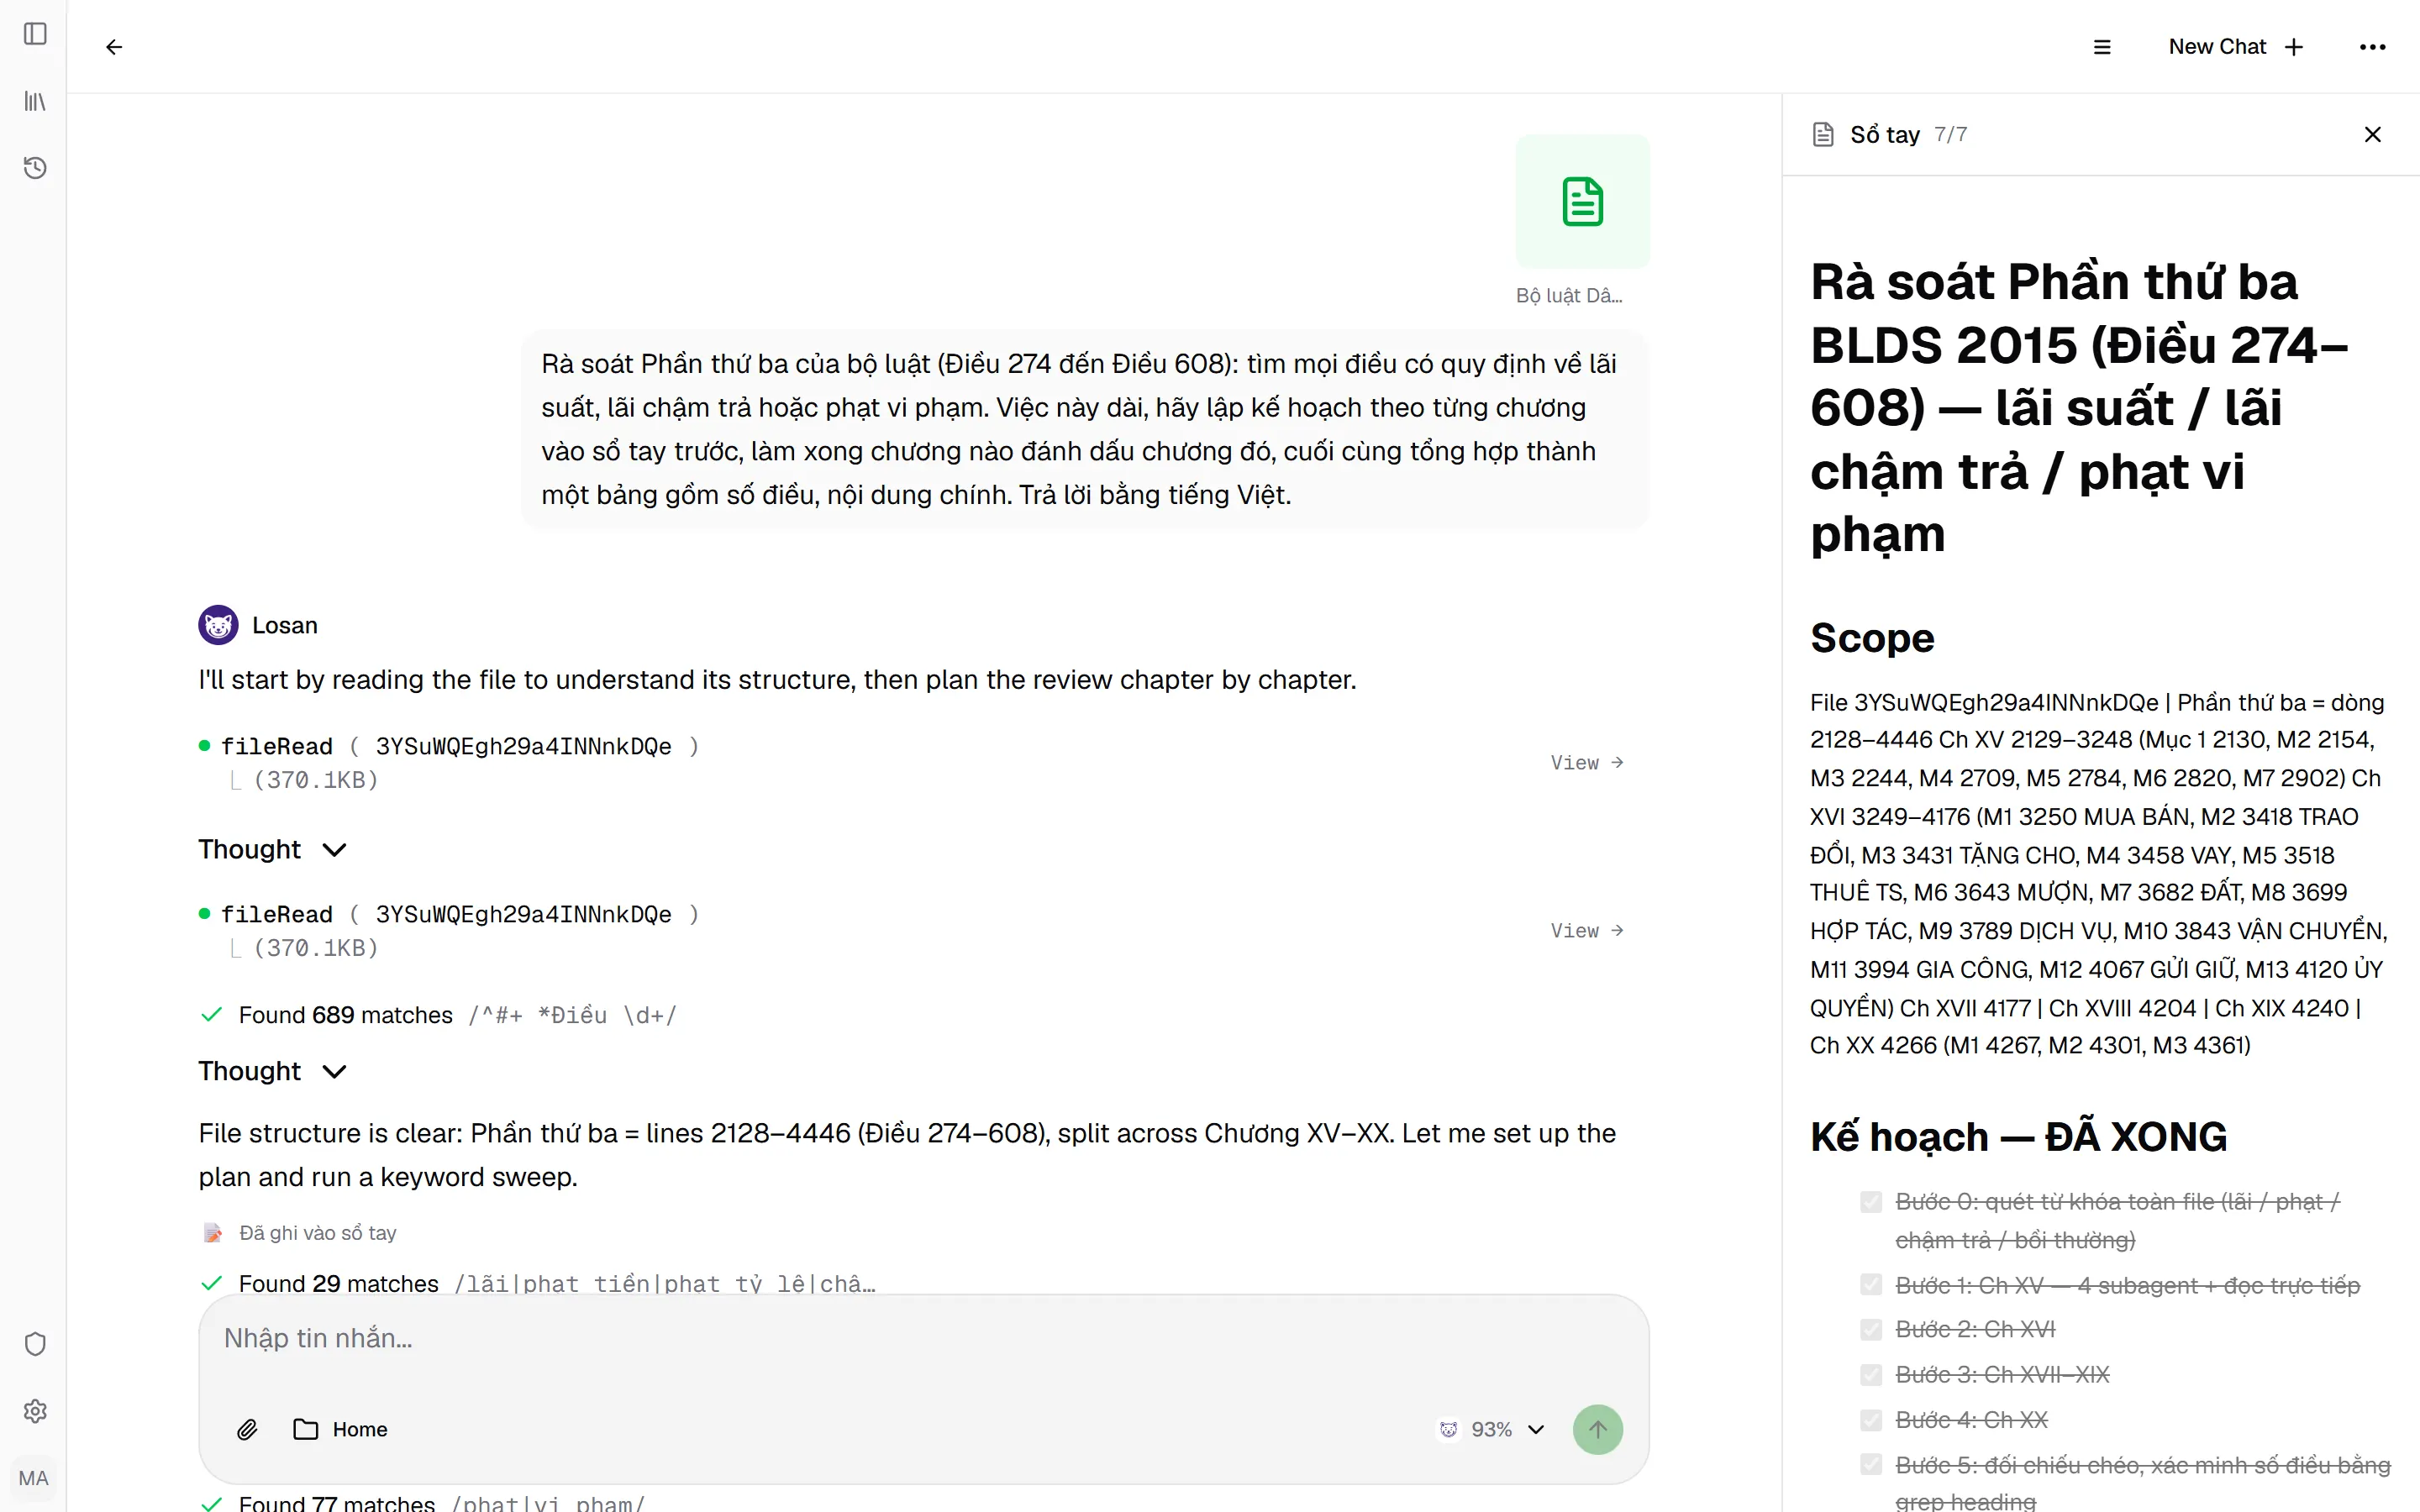
Suy hao ngữ cảnh khác "tràn ngữ cảnh" thế nào?
Hai hiện tượng hay bị gộp làm một, nhưng cách chữa khác nhau:
| Tràn ngữ cảnh | Suy hao ngữ cảnh | |
|---|---|---|
| Xảy ra khi | Tài liệu + lịch sử chat vượt cửa sổ của mô hình | Vẫn nằm trong cửa sổ, nhưng đã dài và nhiều lượt |
| Biểu hiện | AI như chưa từng thấy phần đầu | AI vẫn "thấy" nhưng dùng sai, bỏ sót, trả lời chập chờn |
| Cách chữa chính | Cắt tài liệu, chia để trị | Gọn ngữ cảnh, mở chat mới, giao việc đầy đủ một lần |
Tràn ngữ cảnh và cách chia nhỏ tài liệu đã được phân tích ở bài vì sao ChatGPT quên nội dung khi dán tài liệu dài. Bài này nói về thứ khó nhận ra hơn: mọi thứ vẫn nằm trong cửa sổ, mà câu trả lời vẫn tệ đi.
Bằng chứng: các nghiên cứu nói gì
Chroma — "Context Rot" (07/2025). Nhóm nghiên cứu thử 18 mô hình, gồm GPT-4.1, Claude 4, Gemini 2.5 và Qwen3, trên các tác vụ cố tình làm rất đơn giản để chỉ đo tác động của độ dài. Kết luận: hiệu năng giảm khi đầu vào dài ra, và giảm không đều, khó đoán trước. Khi trong ngữ cảnh có thông tin gần giống thông tin cần tìm (nhiễu cùng chủ đề), mức giảm còn rõ hơn.
NoLiMa (ICML 2025). Các phép thử "tìm kim đáy bể" thông thường dễ vì câu hỏi trùng chữ với thông tin cần tìm. NoLiMa bỏ sự trùng chữ đó, buộc mô hình phải suy ra mối liên hệ. Ở 32.000 token, GPT-4o tụt từ 99,3% xuống 69,7%, và phần lớn mô hình được thử rơi xuống dưới một nửa mức của ngữ cảnh ngắn.
Laban và cộng sự — "LLMs Get Lost In Multi-Turn Conversation" (2025). Cùng một việc, giao đủ yêu cầu trong một lượt so với nhả dần qua nhiều lượt như người dùng hay làm: kết quả giảm trung bình 39% trên sáu loại tác vụ. Phần giảm chủ yếu đến từ việc thiếu ổn định chứ không phải mất năng lực. Mô hình đoán sớm ở các lượt đầu, rồi bám vào phỏng đoán đó, và khi đã đi lạc thì hiếm khi tự quay lại.
Chúng tôi tự đo bằng tiếng Việt
Các nghiên cứu trên chủ yếu đo bằng tiếng Anh. Chúng tôi chạy lại hai phép thử nhỏ bằng tiếng Việt trên mô hình mặc định của LOSAN (tắt chế độ suy luận, mỗi phép thử lặp lại nhiều lần):
Phép thử 1 — tìm thông tin không trùng chữ, ở nhiều độ dài. Chèn một câu như "Chị Mai vừa mua một căn hộ nhìn thẳng ra cầu Rồng" vào giữa Bộ luật Dân sự 2015, rồi hỏi "Ai có nhà ở Đà Nẵng?". 5 câu như vậy, mỗi câu chạy 5 lần ở mỗi độ dài:
| Độ dài ngữ cảnh | Trả lời đúng |
|---|---|
| ~2.000 token | 24/25 |
| ~20.000 token | 25/25 |
| ~100.000 token | 20/25 |
| ~210.000 token (cả bộ luật) | 24/25 |
Kết quả không tụt đều theo độ dài như nhiều người hình dung, nhưng không ổn định: ở mức 100.000 token, cùng một câu hỏi chạy 5 lần thì có 3 lần trả lời "không có". Đúng điều Chroma mô tả: suy hao không đều và khó đoán.
Phép thử 2 — giao một lần hay nhả dần nhiều lượt. Nhờ viết phần tóm tắt cho một khoá luận mẫu với 5 yêu cầu (cỡ mẫu, hệ số hồi quy, ngôi thứ ba, câu cuối nói về thư viện, 4 từ khoá). Mỗi cách chạy 8 lần:
| Cách giao việc | Đạt đủ 5 yêu cầu |
|---|---|
| Một lượt, đủ yêu cầu ngay từ đầu | 8/8 |
| Nhả từng yêu cầu qua 7 lượt, rồi xin bản hoàn chỉnh | 6/8 |
Hai lần trượt đều làm rơi đúng yêu cầu được nhắc ở lượt thứ sáu. Mẫu còn nhỏ nên đây là tín hiệu, chưa phải kết luận thống kê. Nhưng nó cùng chiều với nghiên cứu của Laban: yêu cầu càng nằm sâu trong cuộc trò chuyện thì càng dễ bị bỏ quên. Cách viết yêu cầu đầy đủ ngay từ đầu nằm ở bài giao việc cho AI một lần hay chia nhiều lượt.
6 dấu hiệu cuộc trò chuyện đang suy hao
- Lỗi đã sửa quay lại. Bạn đã bảo bỏ một ý, vài lượt sau nó xuất hiện lại.
- Yêu cầu ban đầu bị quên. Giọng văn, độ dài, định dạng đã thống nhất từ đầu dần trôi đi.
- Thông tin bị trộn. AI lấy số liệu của tài liệu này gán cho tài liệu kia, hoặc trộn bản nháp cũ với bản mới.
- Câu trả lời chung chung hơn. Ít chi tiết cụ thể, nhiều câu đúng nhưng vô thưởng vô phạt.
- Tự mâu thuẫn. Lượt này khẳng định điều lượt trước phủ nhận.
- Chậm hơn và tốn hạn mức hơn. Mỗi lượt phải đọc lại toàn bộ lịch sử nên thời gian chờ và lượng token tăng dần.
Gặp từ hai dấu hiệu trở lên thì việc sửa tiếp trong cuộc trò chuyện cũ thường tốn công hơn là mở cuộc mới.
Khi nào nên mở cuộc trò chuyện mới: theo tình huống
Học và hỏi đáp kiến thức. Mỗi chủ đề một cuộc trò chuyện. Chuyển từ chương 3 sang chương 4 của môn học thì mở chat mới, vì lịch sử của chương 3 lúc này chỉ là nhiễu.
Viết bài dài (tiểu luận, khoá luận, báo cáo). Mỗi phiên làm việc một cuộc trò chuyện: phiên dàn ý, phiên viết chương 2, phiên soát trích dẫn. Phiên sau nhận bản bàn giao từ phiên trước, không nhận cả lịch sử. Cách chia phiên chi tiết ở bài viết khoá luận trong một đoạn chat dài.
Phân tích tài liệu (hợp đồng, hồ sơ, báo cáo). Mỗi câu hỏi lớn một cuộc trò chuyện, và chỉ đưa vào tài liệu liên quan tới câu hỏi đó. Thêm tài liệu không liên quan không giúp AI hiểu hơn mà còn tạo nhiễu, như phân tích ở bài đưa càng nhiều tài liệu, AI trả lời càng tệ?
Bảng quyết định nhanh
| Tình huống | Tiếp tục chat cũ | Mở chat mới |
|---|---|---|
| Hỏi thêm một chi tiết của câu trả lời vừa rồi | ✅ | |
| Sửa nhỏ câu trả lời vừa rồi (1–2 lần) | ✅ | |
| Đã sửa cùng một lỗi lần thứ ba | ✅ | |
| Chuyển sang chương, chủ đề hoặc tài liệu khác | ✅ | |
| Cuộc trò chuyện đã qua vài chục lượt | ✅ | |
| AI bắt đầu trộn thông tin hoặc tự mâu thuẫn | ✅ |
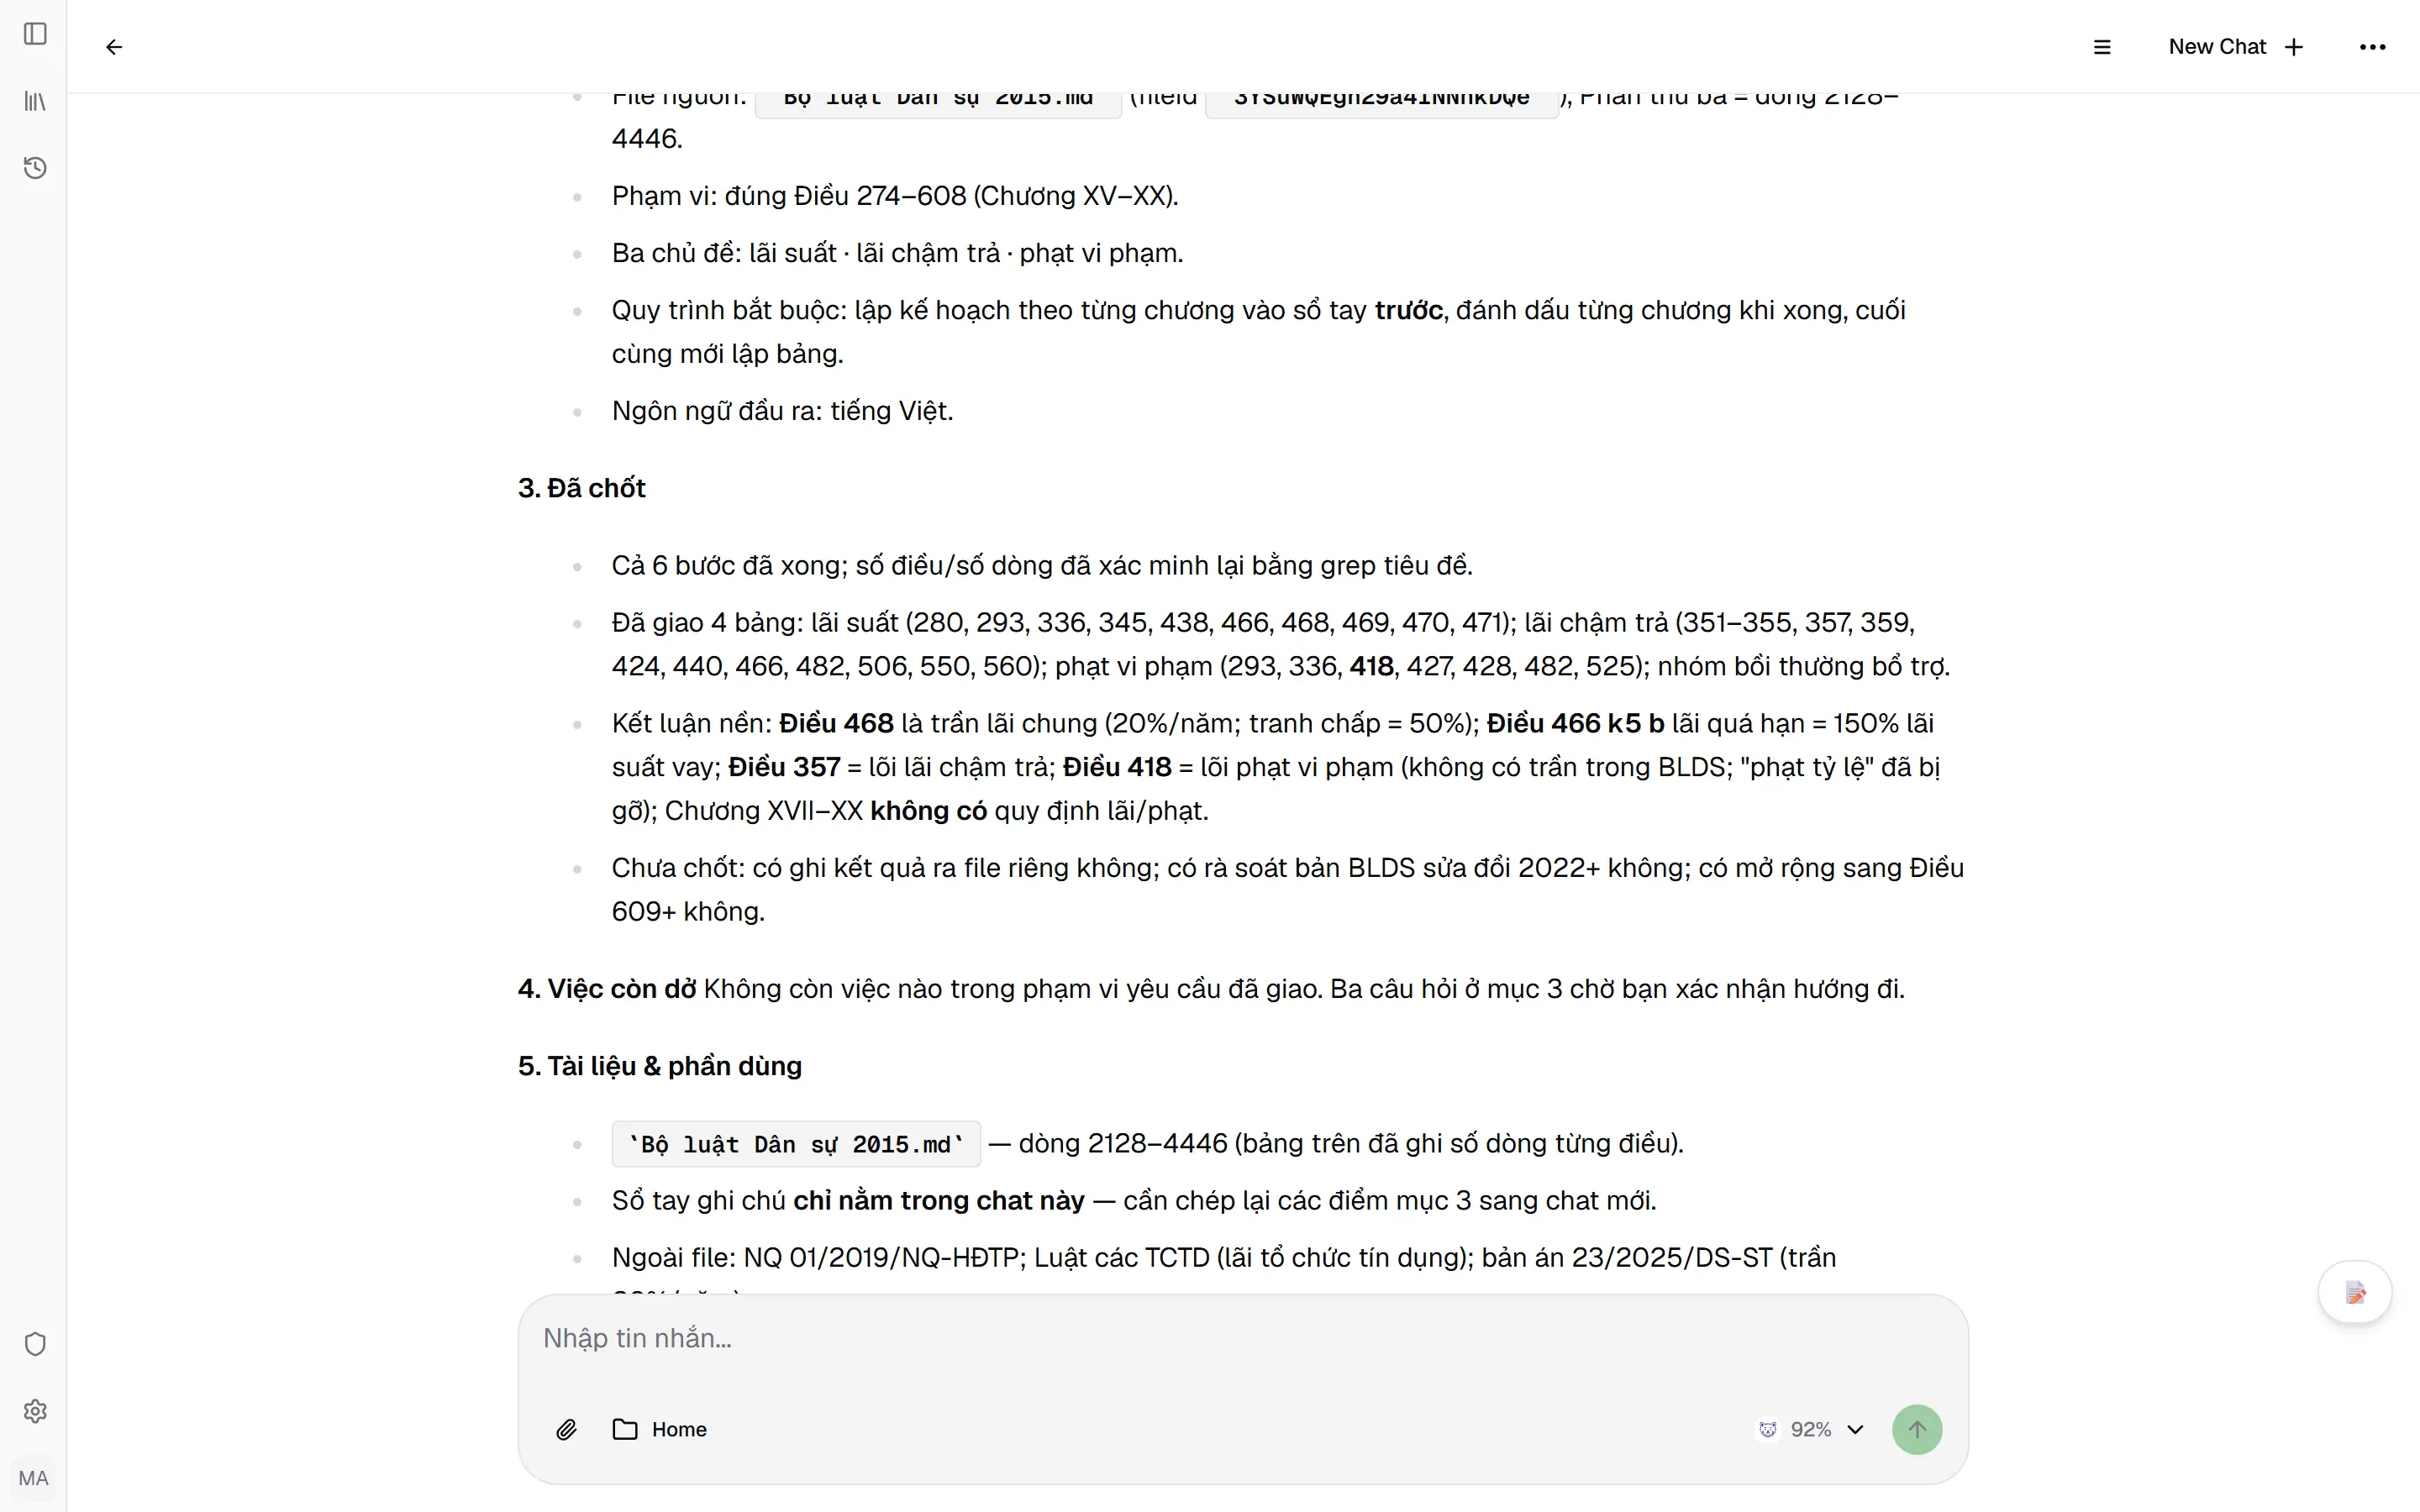
Checklist chống suy hao ngữ cảnh
- Một cuộc trò chuyện chỉ phục vụ một việc
- Yêu cầu quan trọng (giọng văn, độ dài, định dạng, số liệu chuẩn) đưa đủ ngay ở lượt đầu
- Chỉ đưa tài liệu liên quan tới câu hỏi đang hỏi
- Sau 3 lần sửa cùng một lỗi thì mở chat mới thay vì sửa tiếp
- Trước khi mở chat mới, nhờ AI viết bản bàn giao (mẫu ở bài mở chat mới mà không mất gì)
- Với kết quả quan trọng, hỏi lại một lần nữa ở chat mới để xem câu trả lời có ổn định không
LOSAN AI: chống suy hao ngữ cảnh ngay trong cách làm việc
Các mẹo trên đều đúng với mọi công cụ AI, nhưng làm tay thì phiền: phải tự nhớ đã làm đến đâu, tự viết bản bàn giao, tự tải lại tài liệu ở chat mới. Tính năng Dự án của LOSAN AI có sẵn ba cơ chế để bớt phần phiền đó:
- Sổ tay cho từng cuộc trò chuyện. Với việc dài, AI ghi kế hoạch và đánh dấu từng phần đã xong vào sổ tay. Bạn nhìn thấy sổ ở cạnh cuộc trò chuyện, và sổ không bao giờ bị dọn đi, nên dù trò chuyện dài đến đâu thì kế hoạch vẫn nằm đó.
- Tự dọn ngữ cảnh. Nội dung tài liệu AI đã đọc ở các lượt trước được thu gọn thành một dòng ghi nhớ; khi cần lại, AI tự mở lại đúng đoạn đó. Nhờ vậy cuộc trò chuyện không phình lên vì những gì đã xử lý xong.
- Mở chat mới vẫn giữ tài liệu. Tài liệu nằm trong dự án chứ không nằm trong một cuộc trò chuyện. Mở chat mới là chọn lại file bằng nút kẹp giấy, không phải tải lên lại.
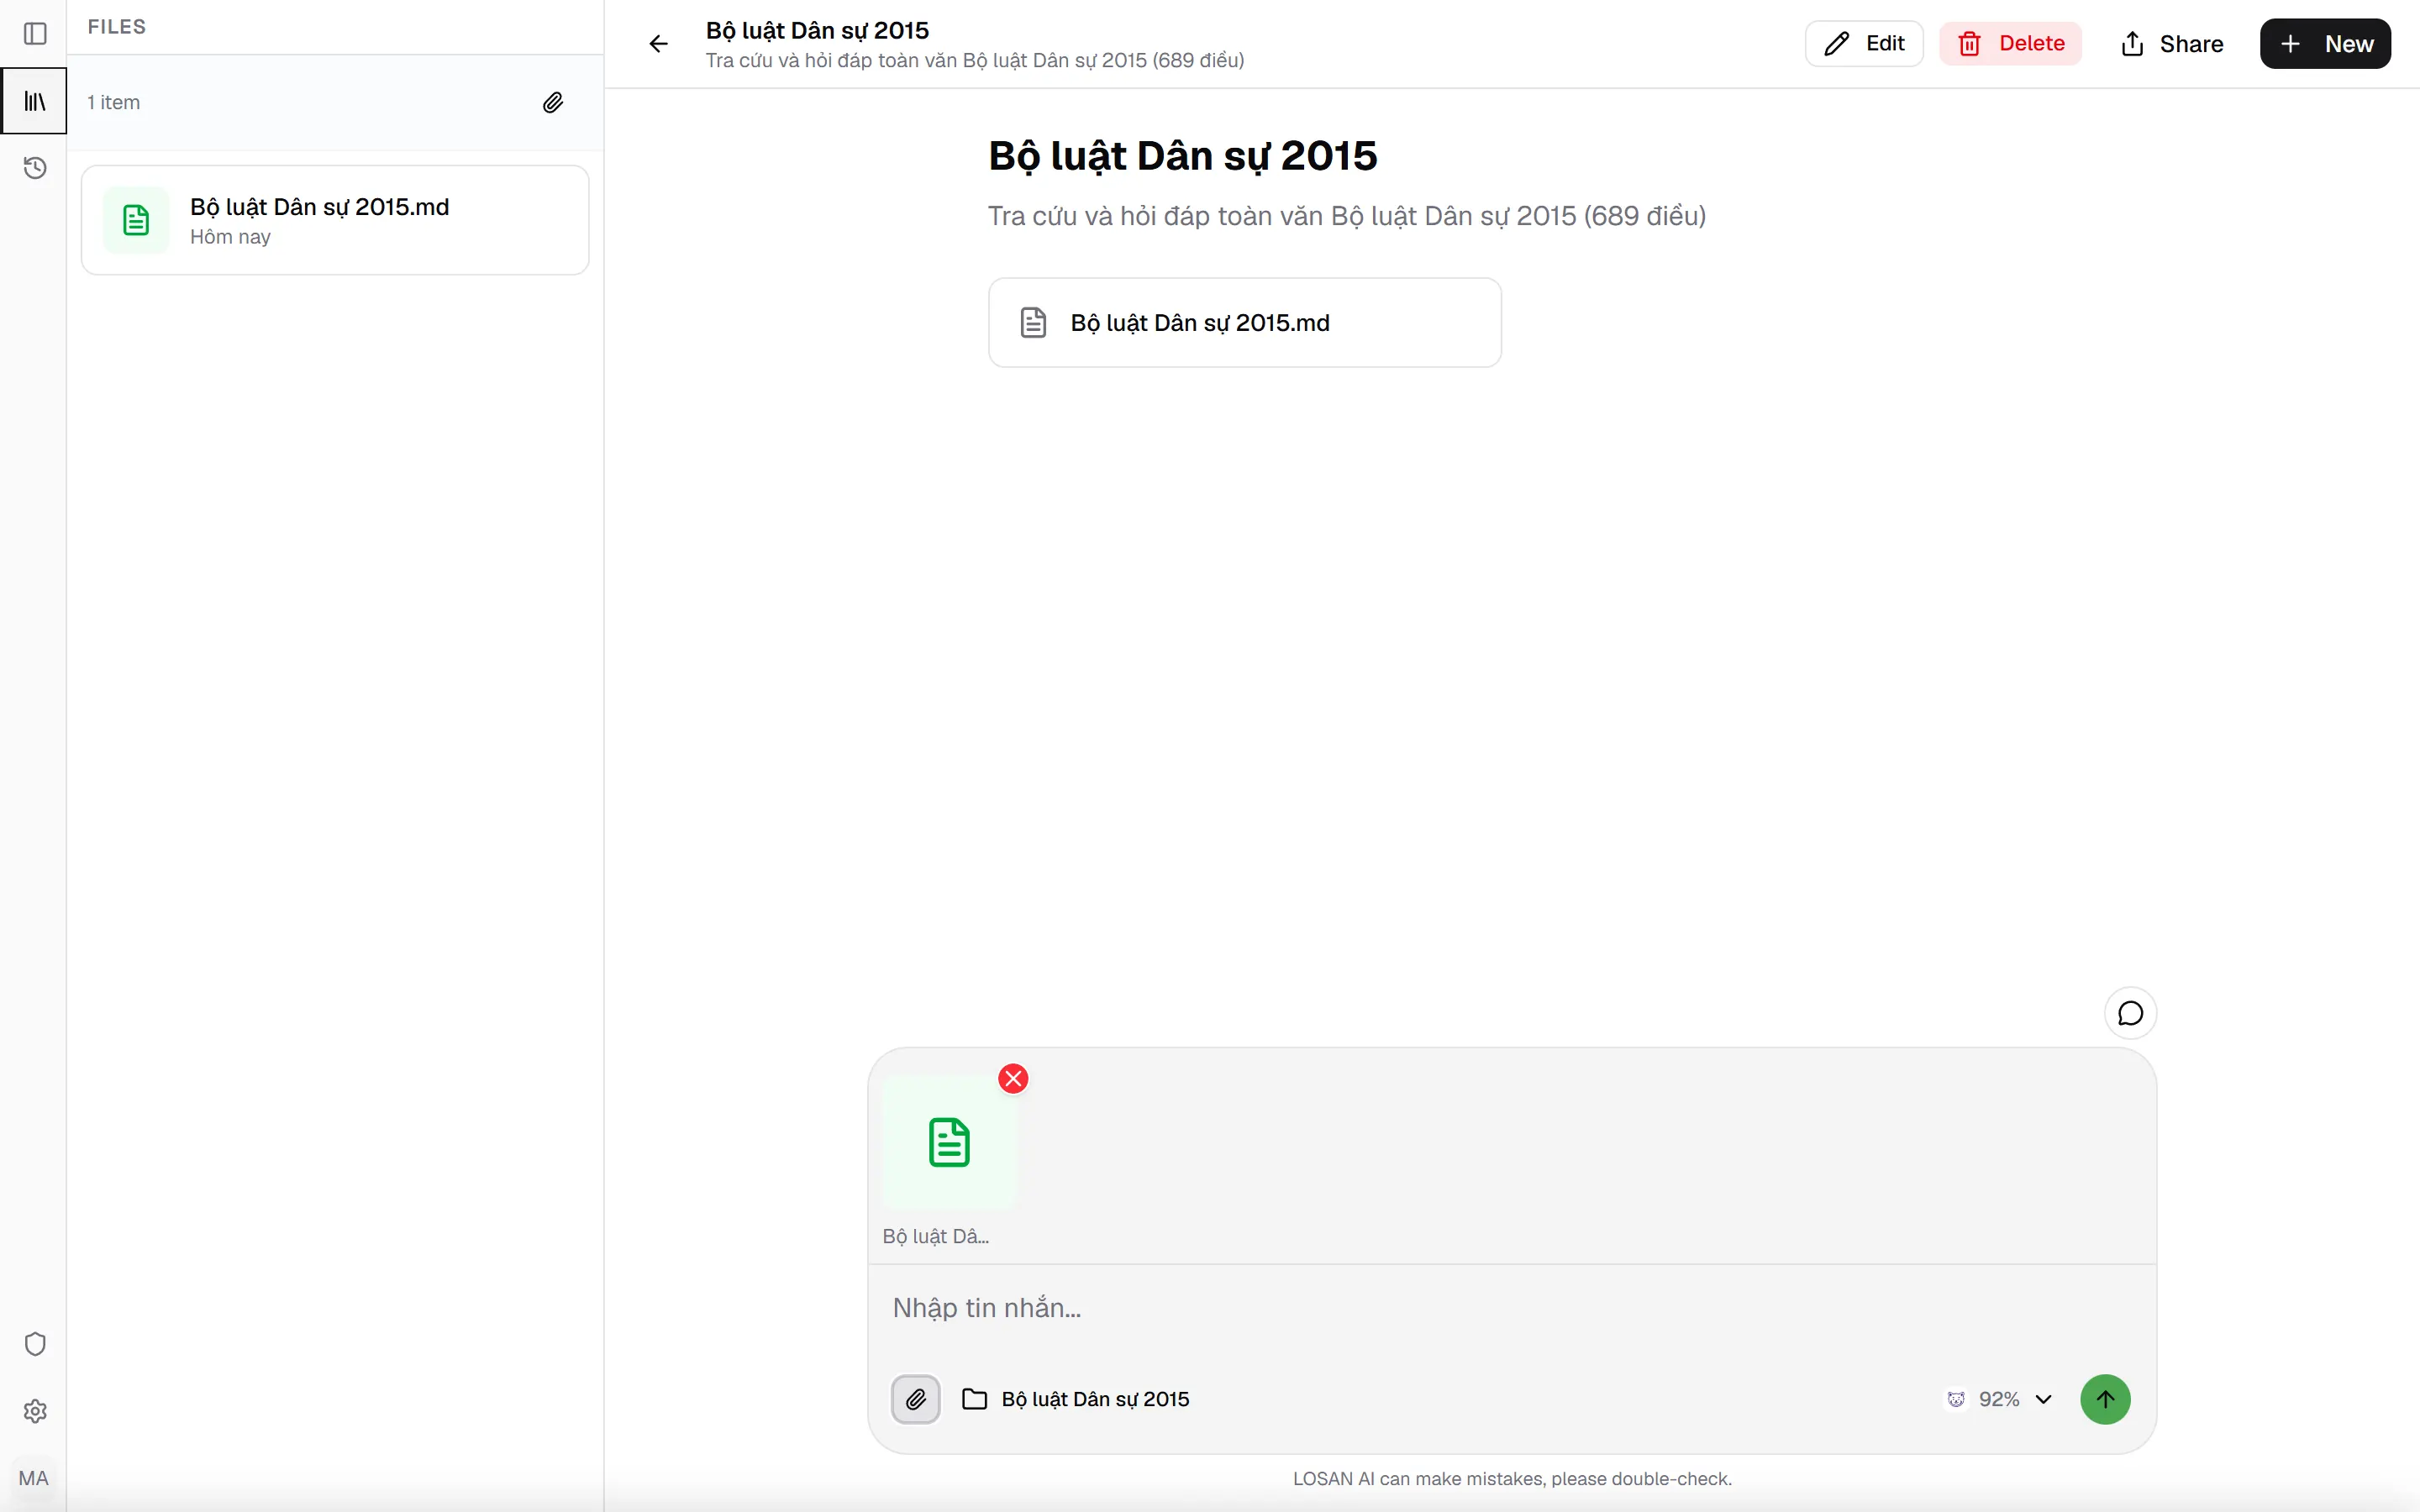
Ba cơ chế này không làm mô hình miễn nhiễm với suy hao, vì chưa mô hình nào miễn nhiễm. Nó giúp bạn giữ ngữ cảnh gọn và mở chat mới không tốn công, đúng hai việc các nghiên cứu ở trên khuyên làm.
👉 Tạo dự án đầu tiên: losan.ai/project
Câu hỏi thường gặp
Mô hình có cửa sổ 1 triệu token thì có bị suy hao không? Có thể có. Cửa sổ lớn giúp chứa được nhiều hơn, nhưng các nghiên cứu cho thấy độ chính xác và độ ổn định vẫn giảm khi ngữ cảnh dài ra. Cửa sổ lớn là chỗ chứa, không phải sự bảo đảm.
Xoá bớt tin nhắn cũ trong cuộc trò chuyện có giúp không? Có, nếu công cụ cho phép. Nhưng cách chắc chắn hơn là mở cuộc trò chuyện mới với bản bàn giao, vì bạn chủ động chọn cái gì được mang sang.
Chế độ "bộ nhớ" của ChatGPT có chống được suy hao không? Bộ nhớ dài hạn lưu những thông tin chung về bạn qua các cuộc trò chuyện. Nó không thay cho việc giữ một cuộc trò chuyện gọn. Thông tin cũ trong bộ nhớ cũng có thể không còn đúng, nên thỉnh thoảng hãy xem lại và xoá các mục đã lỗi thời.
Mở chat mới có làm AI "quên" phong cách mình đã dạy không? Có, nếu bạn không mang phong cách đó sang. Hãy ghi phong cách (giọng văn, độ dài, cách trích dẫn) thành vài dòng cố định trong bản bàn giao, và dán ở đầu mỗi chat mới.
Sao lúc thì AI trả lời đúng, lúc lại sai với cùng một câu hỏi? Mô hình sinh câu trả lời có yếu tố ngẫu nhiên, và ngữ cảnh dài làm biên độ dao động lớn hơn. Phép thử của chúng tôi ở 100.000 token cho thấy cùng một câu hỏi chạy 5 lần có lần đúng, lần sai. Với kết quả quan trọng, hãy hỏi lại ở một cuộc trò chuyện mới để đối chiếu.
Bao nhiêu lượt thì nên mở chat mới? Không có con số chung. Hãy dựa vào sáu dấu hiệu ở trên, thay vì đếm lượt. Nhưng nếu một cuộc trò chuyện đã đổi sang việc khác, thì đó là lúc mở chat mới, dù mới được vài lượt.
Lưu ý và bài liên quan
Bài viết cập nhật 26/10/2026. Hai phép thử tiếng Việt thực hiện ngày 26/10/2026 trên mô hình mặc định của LOSAN (MiniMax-M3, tắt chế độ suy luận), cỡ mẫu nhỏ (25 lần mỗi độ dài ở phép thử 1, 8 lần mỗi cách ở phép thử 2). Kết quả là tín hiệu tham khảo, không phải đánh giá đầy đủ của mô hình.
Nguồn: Hong, K., Troynikov, A., & Huber, J. (2025). Context Rot: How Increasing Input Tokens Impacts LLM Performance. Chroma Research · Modarressi, A. và cộng sự (2025). NoLiMa: Long-Context Evaluation Beyond Literal Matching. ICML 2025 · Laban, P., Hayashi, H., Zhou, Y., & Neville, J. (2025). LLMs Get Lost In Multi-Turn Conversation. arXiv:2505.06120.
Đọc tiếp trong cụm suy hao ngữ cảnh: