Losan tiết kiệm token thế nào: ba cách ăn kiêng cho trợ lý AI
Losan tiết kiệm token thế nào: ba cách ăn kiêng cho trợ lý AI
Mỗi lần bạn gửi một tin nhắn cho trợ lý AI, thứ bạn gõ chỉ là một phần nhỏ của cái thực sự được gửi đi. Phần còn lại là "hành lý" mà trợ lý phải mang theo ở mọi lượt. Bản cập nhật mới của Losan là một đợt ăn kiêng cho chỗ hành lý đó. Bài này kể nó là gì, vì sao nó liên quan tới bạn, và chúng tôi đã đo được gì (và chưa đo được gì).
Token là gì, và vì sao bạn nên quan tâm
Mô hình AI không đọc chữ như người. Nó cắt văn bản thành những mẩu nhỏ gọi là token. Với tiếng Việt và tiếng Anh, trung bình khoảng 3–4 ký tự là một token.
Mỗi lượt chat, mô hình phải đọc lại toàn bộ những gì cần cho lượt đó: lời dặn hệ thống, lịch sử hội thoại, và mô tả các công cụ nó được phép dùng (đọc file, tìm web, vẽ sơ đồ, làm slide, tạo file Excel…). Bạn không thấy phần này, nhưng mô hình đọc nó ở mọi tin nhắn.
Token nhiều thì có ba hệ quả mà bạn cảm nhận trực tiếp:
- Chậm hơn. Mô hình phải đọc xong đầu vào mới bắt đầu trả lời.
- Tốn hơn. Chi phí chạy AI tính theo token. Phần hành lý càng nhẹ, chúng tôi càng dễ giữ giá gói ở mức thấp cho sinh viên và người đi làm.
- Hội thoại ngắn hơn. Mô hình có một giới hạn đọc mỗi lượt. Hành lý chiếm chỗ nào thì tài liệu và lịch sử của bạn mất chỗ đó.
Hành lý của Losan nặng tới đâu
Ngày 28-10 chúng tôi cân lại. Mỗi lượt chat, Losan gửi kèm 22 công cụ, tổng cộng khoảng 12,2 nghìn token cố định, và 96% trong số đó là mô tả công cụ. Nghĩa là trước khi đọc câu hỏi của bạn, mô hình đã phải đọc một cuốn hướng dẫn sử dụng dày cộp.
Điều đáng nói là phần lớn cuốn hướng dẫn đó hiếm khi được dùng. Cũng trong lần đo này: công cụ vẽ chỉ xuất hiện ở khoảng 6% lượt chat, làm slide 1,6%, tạo ảnh 1,4%. Mang chúng theo ở 100% lượt là mang thừa.
Nguyên tắc chúng tôi chọn: mô hình như một người, công cụ như sách. Người làm việc giỏi không vác cả thư viện đi khắp nơi; họ để sách hay dùng trên bàn và mở sách khác khi gặp việc.
Cách 1: Công cụ hiếm chỉ "mở sách" khi cần (ToolSearch)
Các công cụ hiếm dùng (vẽ, slide, tạo ảnh, Excel…) được cất khỏi danh sách mang theo. Thay vào đó, mô hình có một công cụ nhỏ tên ToolSearch. Khi bạn nhờ "làm cho mình file Excel chi tiêu", mô hình gọi ToolSearch để lấy hướng dẫn của công cụ Excel, rồi dùng công cụ đó như bình thường.
Phần khó nằm ở chỗ này: nếu cứ thêm công cụ vào danh sách giữa chừng, ta sẽ phá mất một cơ chế tiết kiệm khác là bộ nhớ đệm (cache, nói ở cách 3). Trong thử nghiệm của chúng tôi, chỉ cần đổi danh sách công cụ giữa cuộc chat là tỉ lệ dùng lại bộ nhớ đệm rơi xuống còn 22–40% với MiniMax, 0–14% với DeepSeek. Vì vậy Losan giữ danh sách công cụ giống hệt nhau ở mọi lượt, và chỉ nối phần hướng dẫn công cụ vào cuối cuộc hội thoại khi cần. Đo trong cùng thử nghiệm, cách này giữ được 97–98% bộ nhớ đệm.
Để chắc mô hình không bị "lạc" khi phải tự tìm công cụ, chúng tôi chạy bộ kiểm thử trên MiniMax-M3 (mô hình mặc định của Losan) với các việc như vẽ sơ đồ, làm slide, tạo ảnh, làm bảng Excel: 9/9 lượt mô hình gọi ToolSearch đúng một lần rồi dùng ngay công cụ thật, không lượt nào dừng giữa chừng.
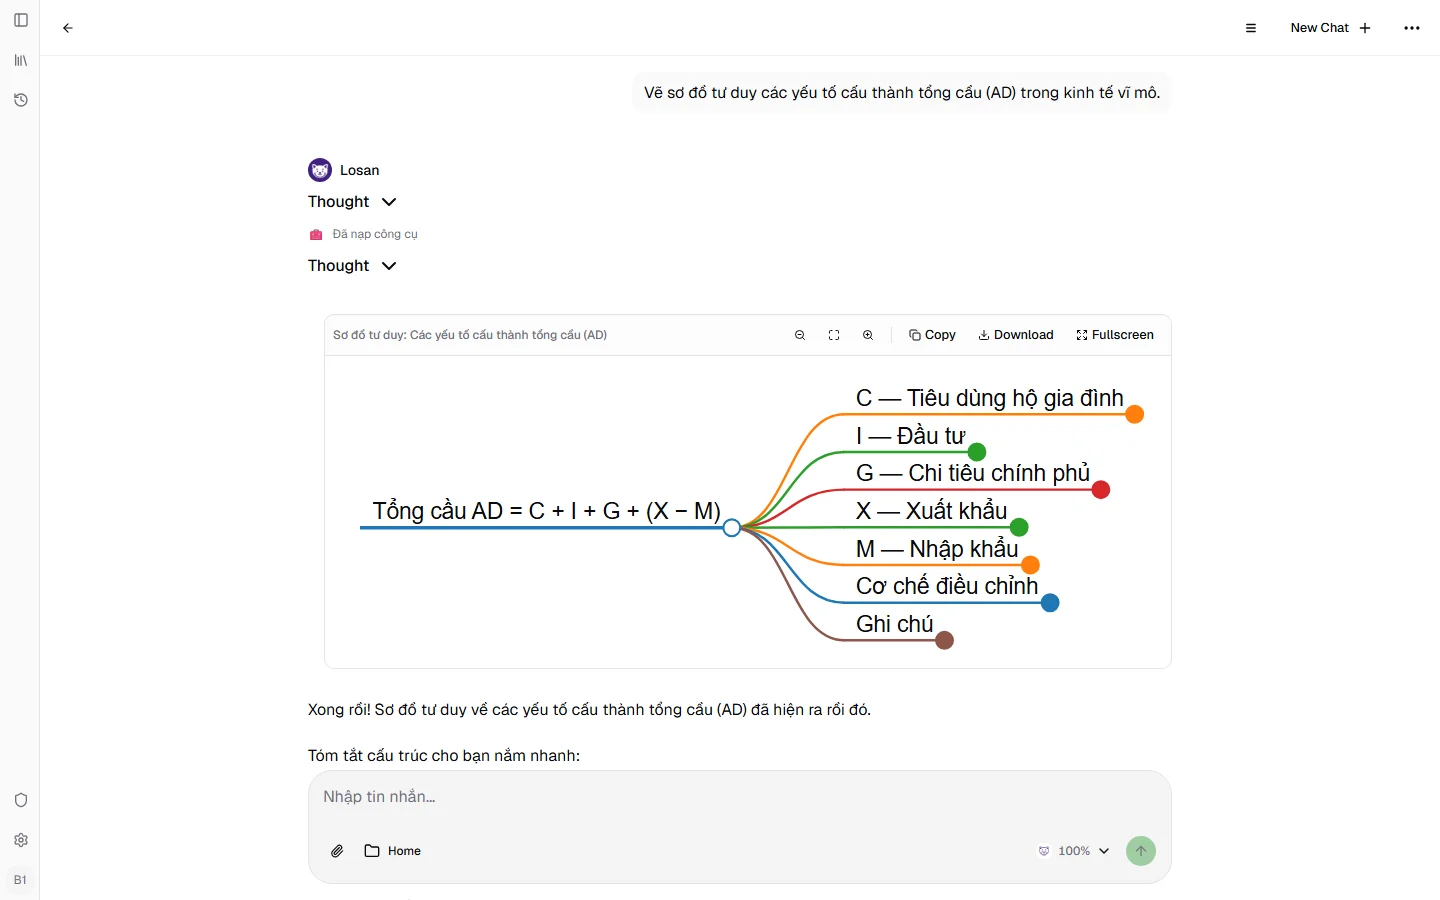
Nhờ vẽ sơ đồ tư duy: dòng "Đã nạp công cụ" là lúc mô hình gọi ToolSearch lấy công cụ vẽ, ngay sau đó sơ đồ hiện ra. Chụp trên bản thử nghiệm của Losan.
Cách 2: Kỹ năng chuyên môn nạp theo việc (Skill)
Có những việc cần một bộ hướng dẫn dài, nhưng chỉ ít người dùng tới. Ví dụ: rà soát một hợp đồng theo luật Việt Nam còn hiệu lực, theo đúng cách một văn phòng luật vẫn làm.
Nhét bộ hướng dẫn đó vào mọi cuộc chat thì ai cũng phải "trả" phần token ấy, kể cả người chỉ hỏi bài Triết. Nên chúng tôi đóng nó thành một Skill: mỗi lượt mô hình chỉ thấy một dòng giới thiệu ngắn, kiểu "dùng khi cần rà hợp đồng". Khi bạn gửi hợp đồng nhờ rà, mô hình tự mở Skill, đọc trọn bộ hướng dẫn, rồi làm theo. Cũng như ToolSearch, phần hướng dẫn được nối vào cuối hội thoại, không đụng tới phần đầu, nên không làm vỡ bộ nhớ đệm.
Trong thử nghiệm với một hợp đồng mẫu có cài sẵn 4 lỗi, mô hình (DeepSeek, trong bộ thử) tự gọi Skill rà hợp đồng ở cả 2/2 lượt chạy và bắt được đủ 4/4 lỗi. Hai lượt là con số nhỏ; chúng tôi sẽ đo thêm với hợp đồng thật.
Cách 3: Lịch sử chỉ được viết thêm, không sửa lại (để bộ nhớ đệm hoạt động)
Các nhà cung cấp mô hình có một cơ chế gọi là prompt cache: nếu phần đầu của yêu cầu giống hệt lần trước, họ không phải đọc lại phần đó từ đầu. Phần được dùng lại xử lý nhanh hơn và rẻ hơn nhiều.
Điều kiện là "giống hệt từng ký tự". Chỉ cần sửa một chữ ở đầu, mọi thứ phía sau phải đọc lại. Trước đây Losan vô tình làm vỡ điều kiện này: lời dặn hệ thống có ghi giờ tới từng phút, nên cứ qua một phút là phần đầu đổi.
Bây giờ Losan theo một luật đơn giản: lịch sử hội thoại chỉ được viết thêm vào cuối, không bao giờ sửa lại. Lời dặn hệ thống chỉ giữ phần tĩnh. Những thứ thay đổi theo từng lượt (giờ hiện tại, file bạn đang mở, sổ ghi chú) được gắn vào chính tin nhắn của lượt đó, rồi giữ nguyên ở các lượt sau. ToolSearch và Skill ở trên cũng tuân theo đúng luật này.
Luật này đã chạy trước bản cập nhật. Trong 7 ngày tính tới 30-10, phần đầu vào của chat trên Losan được dùng lại từ bộ nhớ đệm ở mức: MiniMax-M3 85,8%, DeepSeek 82–87%, MiniMax-M3.1 79%. Bản cập nhật lần này được thiết kế để không làm giảm các con số đó; chúng tôi sẽ đo lại sau khi phát hành.
Trước và sau, bằng số
Bảng dưới là phần mô tả công cụ gửi kèm mỗi lượt chat, đo bằng công cụ đếm ký tự trong môi trường thử nghiệm (khoảng 3,45 ký tự ≈ 1 token):
| Mốc | Công cụ gửi mỗi lượt | Ước tính token mỗi lượt |
|---|---|---|
| Trước (28-10) | 22 công cụ, mang theo tất cả | ~12,2 nghìn |
| Sau khi viết gọn mô tả | 22 công cụ, mô tả ngắn hơn | ~9,2 nghìn |
| Sau khi công cụ hiếm nạp khi cần | công cụ chính + ToolSearch | ~4,0 nghìn |
Tính theo ký tự, phần mô tả công cụ giảm từ 31.312 xuống 13.908, tức còn chưa tới một nửa. Phần này là đo trên bản thử nghiệm, chưa phải số trên hệ thống thật.
Điều này có ý nghĩa gì với bạn
- Phần lớn cuộc chat (hỏi bài, viết, sửa văn bản) sẽ không phải mang theo công cụ vẽ, slide, ảnh, Excel nữa. Mô hình có ít thứ phải đọc hơn trước khi trả lời bạn.
- Khi bạn cần những công cụ đó, chúng vẫn ở đó. Cái giá là mô hình mất thêm một bước nhỏ để "mở sách".
- Phần token tiết kiệm được là chỗ cho tài liệu và lịch sử của bạn, và là một phần lý do chúng tôi giữ được các gói giá thấp.
Những gì chúng tôi chưa biết
Bản cập nhật đã hoàn tất nhưng chưa phát hành tới người dùng tại thời điểm viết bài. Mọi con số "sau" ở trên đến từ môi trường thử nghiệm và bộ kiểm thử với số lượt nhỏ. Sau khi phát hành, chúng tôi sẽ theo dõi 2–3 ngày: số token mỗi lượt chat, tỉ lệ dùng lại bộ nhớ đệm, và bao nhiêu cuộc chat thực sự mở công cụ hiếm hay dùng Skill. Bài này sẽ được cập nhật bằng số thật.
Còn một việc nữa đang làm: viết gọn phần hướng dẫn còn lại. Ước tính của chúng tôi là có thể xuống quanh 2,5–3 nghìn token mỗi lượt, nhưng đó là ước tính, chưa đo.