Token trong AI là gì? Vì sao tiếng Việt tốn token hơn và 7 cách tiết kiệm token khi chat (cập nhật 11/2026)
Token trong AI là gì? Vì sao tiếng Việt tốn token hơn và 7 cách tiết kiệm token khi chat (cập nhật 11/2026)
Trả lời ngay:
- Token là đơn vị nhỏ mà AI dùng để đọc và viết: một mẩu chữ, có thể là một từ ngắn, một nửa từ, hoặc một dấu câu. AI không đếm theo từ hay theo ký tự, và hạn mức, độ dài ngữ cảnh của chatbot đều tính theo token.
- Tiếng Việt thường tốn nhiều token hơn tiếng Anh cho cùng một ý. Trong ví dụ chúng tôi tự đếm bên dưới, một câu tiếng Việt tốn 24 token còn câu tiếng Anh cùng nghĩa tốn 17. Token đi ở ba chỗ: phần bạn gửi vào, lịch sử cuộc trò chuyện được gửi lại mỗi lượt, và phần AI viết ra.
- Cách tiết kiệm không phải là gõ cụt lủn, mà là đừng đưa cho AI thứ nó không cần: dán đúng đoạn cần, dọn chữ thừa, mở chat mới khi đổi việc, sửa tin gốc thay vì gửi thêm tin đính chính, nói rõ độ dài câu trả lời, và chọn mô hình hợp việc. Dán ít hơn thường còn giúp câu trả lời đúng hơn.

Dán cả file để hỏi một câu
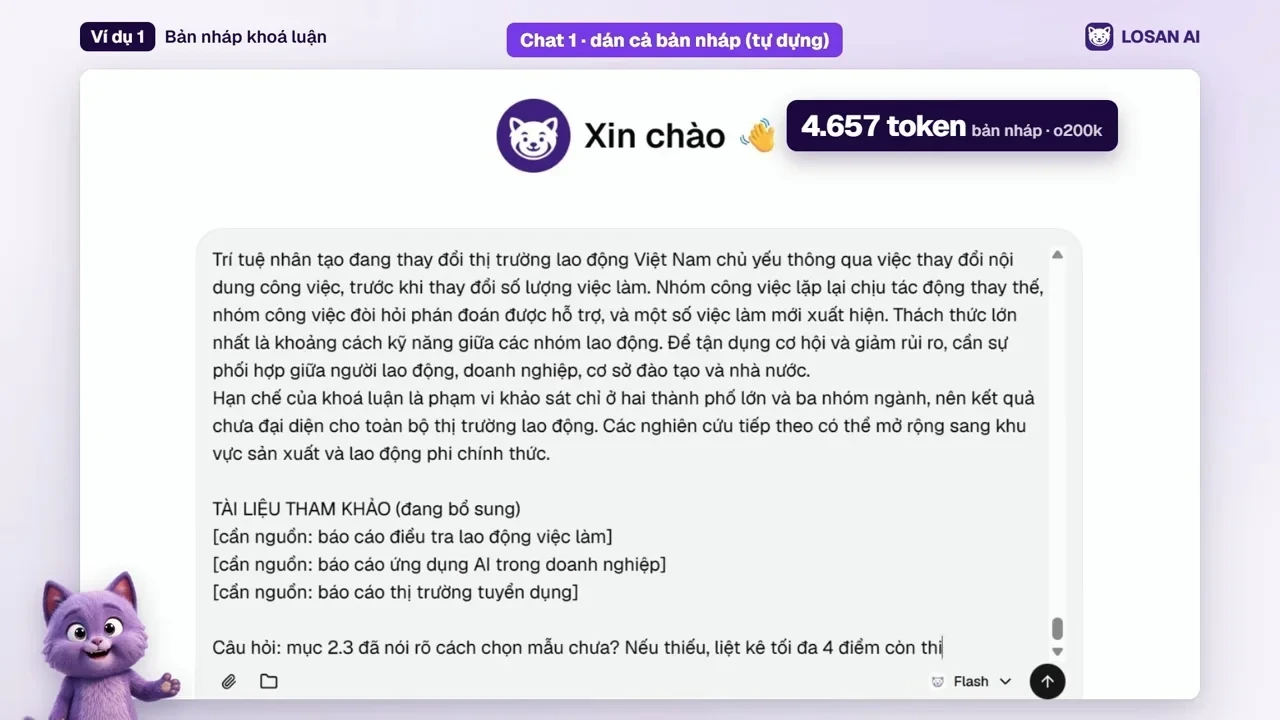
Hãy hình dung một sinh viên có bản nháp khoá luận 80 trang, chỉ muốn hỏi AI một câu: "Phần kết luận chương 2 đã trả lời câu hỏi nghiên cứu chưa?" Em dán nguyên cả file rồi gõ câu hỏi ở cuối. Một lúc sau chatbot báo sắp hết lượt dùng, hoặc câu trả lời bắt đầu chung chung và sai chi tiết dù đã có toàn bộ tài liệu. Mỗi chữ dán vào đều bị đếm, và bài này giải thích cơ chế đó cùng 7 cách làm ít tốn hơn. Nếu bạn đã gặp cảnh chat càng lâu AI càng trả lời kém, bài Vì sao chat với AI càng lâu càng trả lời kém là phần nối tiếp của bài này.
▶ Xem đoạn mở đầu trong video: 0:00
Token là gì, và vì sao tiếng Việt tốn hơn
Token là mẩu chữ mà AI dùng làm đơn vị đọc và viết. Trước khi xử lý, mọi văn bản bạn gửi được một bộ tách token cắt thành các mẩu. Từ tiếng Anh phổ biến thường là một token. Từ dài hoặc ít gặp bị cắt thành vài token. Dấu câu, khoảng trắng, chữ có dấu cũng có thể thành token riêng.
Không có một bộ tách chung cho mọi AI. Mỗi mô hình dùng bộ tách của riêng nó, nên cùng một câu có thể ra số token khác nhau. Con số bên dưới vì thế chỉ là minh hoạ cho một bộ tách cụ thể, không phải số bạn sẽ thấy ở mọi chatbot.
Chúng tôi tự đếm bằng bộ tách o200k_base (bộ tách của GPT-4o) vào ngày 14/11/2026, bằng thư viện gpt-tokenizer chạy trên Node. Ba cặp câu dưới đây là câu tự viết:
| Câu | Tiếng Việt | Tiếng Anh cùng nghĩa |
|---|---|---|
| Viết tiểu luận | "Tôi cần viết một bài tiểu luận về tác động của trí tuệ nhân tạo đến thị trường lao động." (88 ký tự, 24 token) | "I need to write an essay about the impact of artificial intelligence on the labor market." (89 ký tự, 17 token) |
| Nhờ tóm tắt | "Xin chào, bạn có thể tóm tắt giúp tôi đoạn văn này không?" (57 ký tự, 18 token) | "Hello, could you summarize this paragraph for me?" (49 ký tự, 10 token) |
| Địa danh | "Hà Nội" (6 ký tự, 3 token) | "Hanoi" (5 ký tự, 2 token) |
Cùng độ dài ký tự gần như bằng nhau, nhưng bản tiếng Việt tốn nhiều token hơn: ở cặp đầu là 24 so với 17, ở cặp thứ hai là 18 so với 10. Lý do chung là các bộ tách thường được xây chủ yếu trên văn bản tiếng Anh, nên chữ Việt có dấu bị cắt vụn hơn. Mức chênh cụ thể phụ thuộc vào từng bộ tách và từng câu, vì vậy đừng hiểu ba cặp ví dụ này là một tỉ lệ cố định.
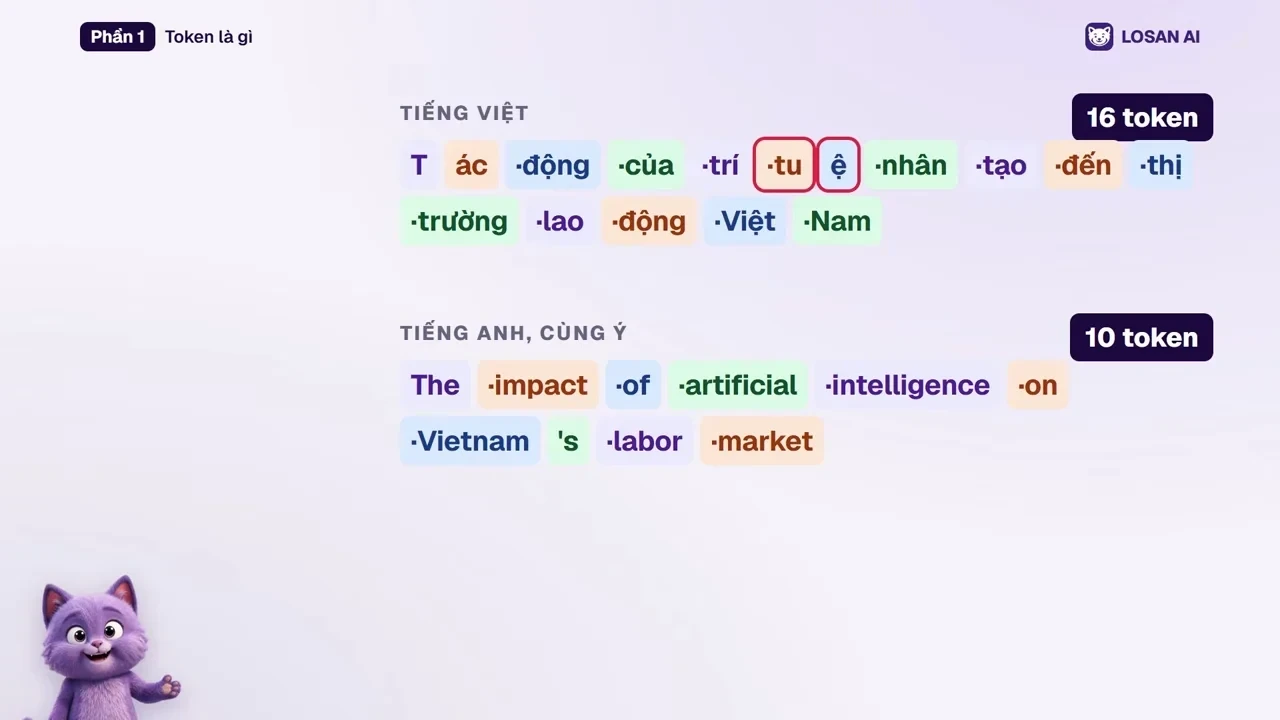
Đừng vì thế mà chuyển sang gõ tiếng Anh nếu bạn viết bài tiếng Việt: chênh lệch trên từng câu nhỏ hơn nhiều so với việc dán thừa vài trang, và đó mới là chỗ bạn kiểm soát được.
▶ 0:49
Token tốn ở đâu: gửi vào, lịch sử, viết ra
Khi bạn bấm gửi, ba khoản được tính:
- Phần gửi vào: câu hỏi của bạn, kèm mọi thứ bạn dán hoặc đính kèm trong lượt đó.
- Lịch sử: các chatbot không có trí nhớ giữa hai tin nhắn theo kiểu người, nên mỗi lượt mới, phần lớn cuộc trò chuyện trước đó được gửi lại cho mô hình đọc. Đoạn bạn dán ở tin thứ nhất vẫn nằm trong những lượt sau.
- Phần viết ra: câu trả lời của AI cũng được đếm.
Nếu tin đầu dán 20.000 token tài liệu, thì mười tin hỏi tiếp sau đó đều mang theo 20.000 token ấy. Chat càng dài, mỗi câu hỏi nhỏ càng "đắt". Cách vận hành chính xác thay đổi theo từng ứng dụng và mô hình, nhưng nguyên tắc chung là vậy.
Ngữ cảnh chất đầy còn làm mô hình dễ bỏ sót chi tiết, xem Đưa càng nhiều tài liệu AI trả lời càng tệ và Vì sao ChatGPT quên nội dung khi dán tài liệu dài.
▶ 1:32
7 cách tiết kiệm token
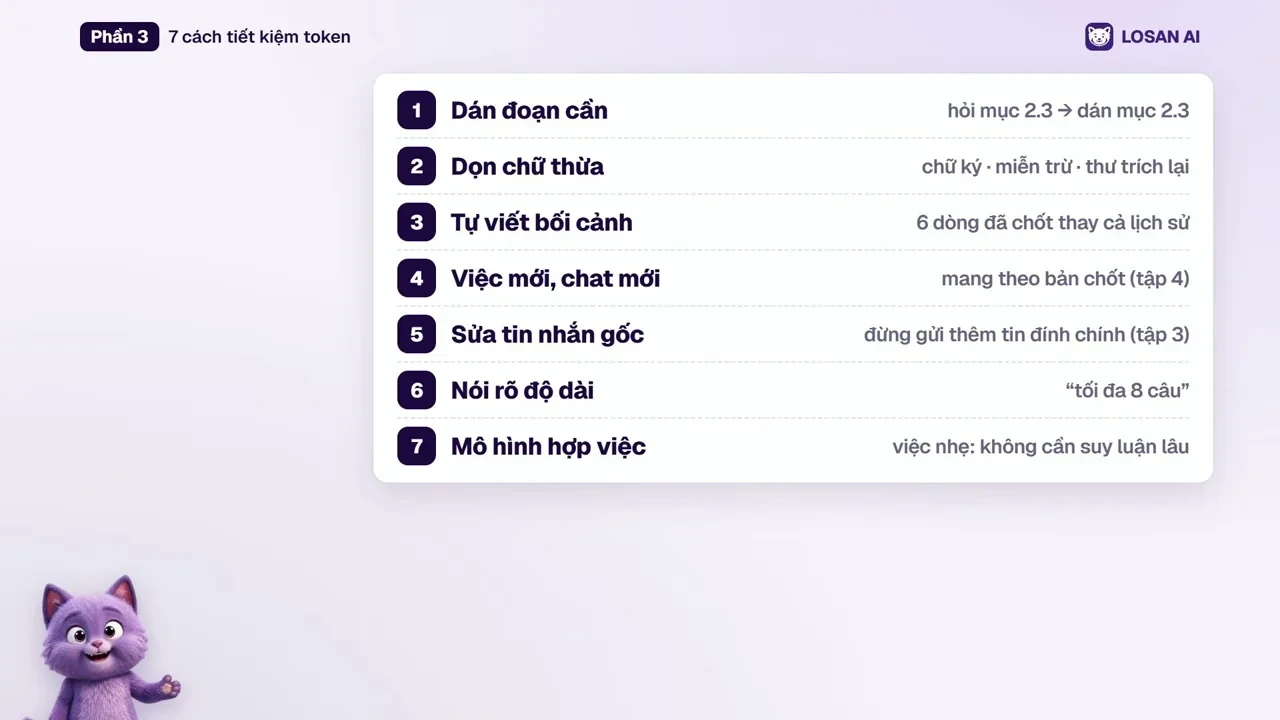
| # | Cách làm | Tiết kiệm ở khoản nào |
|---|---|---|
| 1 | Dán đoạn cần, không dán cả file | Gửi vào |
| 2 | Dọn chữ thừa: chữ ký, câu miễn trừ, phần trích lại thư cũ | Gửi vào |
| 3 | Tự viết vài dòng bối cảnh thay cho cả lịch sử | Lịch sử |
| 4 | Việc mới, chat mới (mang theo bản chốt) | Lịch sử |
| 5 | AI hiểu sai thì sửa tin nhắn gốc, đừng gửi thêm tin đính chính | Lịch sử |
| 6 | Nói rõ độ dài, dạng câu trả lời ("tối đa 8 câu") | Viết ra |
| 7 | Chọn mô hình hợp việc | Cả ba |
1. Dán đoạn cần, không dán cả file. Hỏi về một đoạn thì đưa đoạn đó kèm tên chương, mục. Đừng cắt quá cụt: giữ đủ để người lạ đọc vẫn hiểu.
2. Dọn chữ thừa. Chữ ký, câu miễn trừ trách nhiệm cuối email, phần "Vào ngày... đã viết:" trích lại thư cũ, tiêu đề lặp ở mỗi trang.
3. Tự viết vài dòng bối cảnh thay cho cả lịch sử. Thay vì để AI đọc lại 50 tin nhắn, bạn viết ba dòng: đề tài là gì, đã chốt gì, đang làm đến đâu.
4. Việc mới, chat mới (mang theo bản chốt). Đổi sang việc khác thì mở cuộc trò chuyện mới, để mô hình không phải gánh phần cũ. "Bản chốt" là vài dòng tóm kết quả đã thống nhất, bạn dán vào chat mới. Mẫu bản bàn giao có sẵn trong bài Mở chat mới mà không mất gì.
5. AI hiểu sai thì sửa tin nhắn gốc, đừng gửi thêm tin đính chính. Nếu gửi thêm "không, ý tôi là...", cả câu trả lời sai lẫn câu đính chính nằm lại trong lịch sử, và mọi lượt sau đều mang theo cả hai. Sửa lại tin gốc rồi gửi lại thì lịch sử chỉ còn một nhánh đúng. Không phải ứng dụng nào cũng có nút sửa tin; nếu ứng dụng của bạn không có, hãy mở chat mới kèm bản chốt. Cách sửa từng chỗ sai thay vì bắt AI viết lại cả bài nằm trong AI trả lời chưa ưng thì sửa thế nào.
6. Nói rõ độ dài, dạng câu trả lời. Câu "tối đa 8 câu" hay "một bảng 4 cột, mỗi ô không quá 15 chữ" vừa giảm phần AI viết ra, vừa giảm công đọc của bạn. Bài về định dạng đầu ra nói thêm vì sao "ngắn gọn thôi" vẫn chưa đủ.
7. Chọn mô hình hợp việc. Việc đơn giản như đổi giọng một email, sửa lỗi chính tả thì không cần mô hình mạnh và đắt nhất. Việc nhiều bước, cần lập luận chặt thì mới đáng dùng mô hình mạnh.
▶ 2:20
Ví dụ 1: bản nháp khoá luận, hỏi một câu
Quay lại sinh viên ở đầu bài. Đây là cách làm khác, dùng ba trong bảy cách ở trên:
- Chỉ dán chương cần hỏi, hoặc đúng đoạn kết luận chương 2 cùng đoạn mở đầu của chương đó (cách 1).
- Viết ba dòng bối cảnh thay cho phần còn lại của khoá luận: "Đề tài: ..., câu hỏi nghiên cứu: ..., chương 2 là phần cơ sở lý luận" (cách 3).
- Nói rõ cách trả lời: "Trả lời có/không trước, sau đó nêu tối đa 3 chỗ còn thiếu" (cách 6).
Cách này ít token hơn, và AI cũng ít chỗ lạc sang chương khác. Câu hỏi cần đối chiếu nhiều chương thì làm theo từng cặp chương, như bài Kiểm tra nhất quán khoá luận.
▶ 3:29
Ví dụ 2: chuỗi 40 email, viết một thư trả lời
Tình huống thứ hai, cũng hay gặp ở người đi làm: có một chuỗi 40 email qua lại với khách, cần viết một thư trả lời. Cách quen tay là dán toàn bộ chuỗi.
Chúng tôi dựng thử một email giả định của một công ty giả định (không phải khách thật) rồi đếm bằng o200k_base ngày 14/11/2026:
| Phần | Số token |
|---|---|
| Nội dung chính của email (2 câu) | 34 |
| Chữ ký và câu miễn trừ cuối email (tự viết cho ví dụ) | 139 |
| Một email đầy đủ | 173 |
| Chuỗi 40 email như vậy, chưa kể phần trích lại thư cũ | khoảng 6.920 |
Trong email ví dụ này, chữ ký và miễn trừ chiếm khoảng 4 phần 5 số token, trong khi nội dung thật chỉ khoảng 1 phần 5. Nhưng nếu mỗi thư lại trích nguyên thư trước, số token còn phình thêm theo cấp số cộng, vì thư thứ 40 chứa lại 39 thư trước.
Cách làm tiết kiệm:
- Chỉ giữ nội dung chính của từng thư, bỏ chữ ký, miễn trừ, phần trích lại (cách 2).
- Hoặc, tốt hơn, tự viết 5 đến 6 dòng: khách muốn gì, đã thống nhất những gì, còn vướng gì, hạn chót là khi nào (cách 3). Rồi dán kèm đúng thư mới nhất mà bạn cần trả lời.
- Ghi rõ yêu cầu: "Viết thư trả lời tối đa 120 chữ, giọng lịch sự, xác nhận hạn thứ Sáu" (cách 6).
▶ 4:30
Trên LOSAN: lượt dùng, đính kèm file
Trên LOSAN, hạn mức của mỗi gói được tính theo chi phí AI đã dùng trong một phiên, chứ không đếm số tin nhắn (chúng tôi kiểm lại trong mã nguồn cấu hình các gói). Hệ quả: một tin nhắn dán cả khoá luận tốn nhiều hạn mức hơn hàng chục tin hỏi ngắn. Giao diện chat hiển thị phần trăm hạn mức còn lại, nên bạn nhìn được mình đang dùng nhanh hay chậm. Con số hạn mức cụ thể của từng gói thì thay đổi theo thời gian; xem trang giá của LOSAN để có số mới nhất.
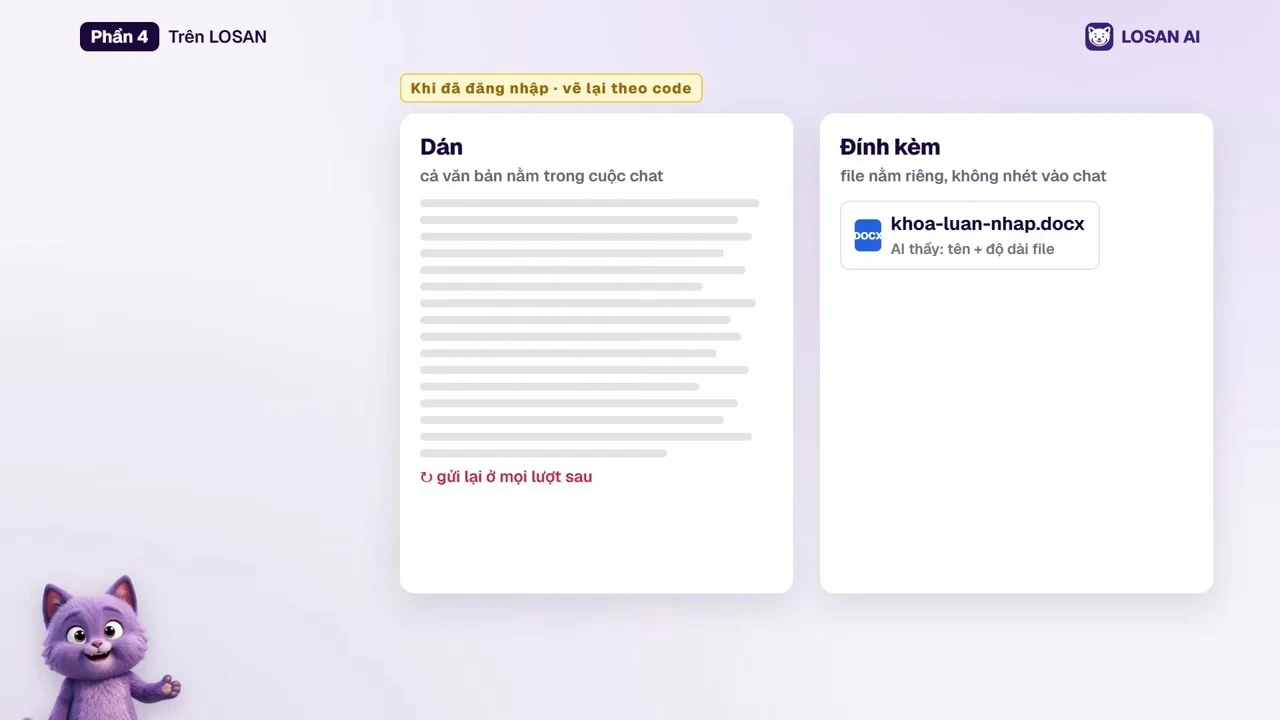
Với tài liệu dài, trên LOSAN nên đính kèm file thay vì dán chữ. Chữ dán vào ô chat nằm luôn trong cuộc trò chuyện và bị gửi lại ở mọi lượt sau. File đính kèm thì nằm riêng: AI chỉ thấy tên file, rồi tự mở và đọc đúng phần cần cho câu hỏi, giống người tra mục lục rồi lật tới trang cần. Dù vậy, hỏi theo từng chương hoặc từng mục vẫn tốt hơn một câu bao trùm cả file, vì câu hỏi rộng buộc AI phải đọc nhiều. Nếu bạn có một bộ tài liệu dùng đi dùng lại cho cùng một đề tài, xem bài Cách dùng Project trong AI: ghi bối cảnh một lần thay vì dán lại mỗi lượt, và bài viết mô tả dự án cho AI cho cách viết phần bối cảnh ấy gọn.
Việc chọn mô hình hợp việc (cách 7) cũng làm được ngay trong ô chat của LOSAN, nơi bạn đổi mô hình trước khi gửi. Còn những mẫu câu lệnh ngắn, đúng dạng để xin câu trả lời gọn, bạn có thể mở ở thư viện prompt hoặc đọc bài 24 mẫu prompt thông dụng.
▶ 5:28
Checklist trước khi bấm gửi
▶ Phần "3 lỗi hay gặp" trong video: 6:22. Ba lỗi chúng tôi gặp nhiều nhất khi tiết kiệm: cắt quá tay đến mất định nghĩa, dán bản chốt do AI tóm mà không đọc lại, và gửi thêm tin đính chính thay vì sửa tin gốc.
- Câu hỏi của tôi chỉ cần đoạn nào? Tôi chỉ dán đoạn đó (và đoạn liền trước nếu cần).
- Đã xoá chữ ký, câu miễn trừ, phần trích lại thư cũ, tiêu đề trang lặp chưa?
- Nếu chat đã dài hoặc đổi sang việc khác: tôi đã viết bản chốt 3 đến 6 dòng và mở chat mới chưa?
- AI vừa hiểu sai: tôi sửa tin gốc, không gửi thêm tin đính chính.
- Tôi đã ghi độ dài và dạng câu trả lời mong muốn chưa?
- Việc này có cần mô hình mạnh nhất không, hay một mô hình nhẹ hơn đã đủ?
Tóm lại
Token là mẩu chữ AI dùng để đọc và viết, và tiếng Việt thường tốn nhiều token hơn tiếng Anh cho cùng một ý. Token tốn ở ba chỗ: gửi vào, lịch sử gửi lại mỗi lượt, và phần viết ra. Bảy cách tiết kiệm đều quy về một việc: chỉ đưa cho AI thứ nó cần để trả lời câu hỏi hiện tại. Nếu chỉ nhớ một cách, hãy nhớ cách số 1, vì dán đúng đoạn cần vừa tiết kiệm hạn mức, vừa thường cho câu trả lời đúng hơn.
▶ 6:53
Câu hỏi thường gặp
Token là gì, một token bằng bao nhiêu chữ? Token là mẩu chữ do bộ tách của mô hình cắt ra, không có quy đổi cố định ra số chữ. Trong ví dụ chúng tôi đếm bằng o200k_base, câu tiếng Việt 88 ký tự ra 24 token, câu tiếng Anh 89 ký tự ra 17 token. Mỗi mô hình có bộ tách riêng nên số sẽ khác.
Vì sao tiếng Việt tốn token hơn tiếng Anh? Vì các bộ tách thường được xây chủ yếu trên văn bản tiếng Anh, nên chữ Việt có dấu thường bị cắt thành nhiều mẩu hơn. Mức chênh phụ thuộc vào bộ tách và vào câu cụ thể, nên bạn nên coi ví dụ ở bài là minh hoạ, không phải tỉ lệ cố định.
Làm sao tiết kiệm token khi dùng ChatGPT, Claude hay Gemini? Nguyên tắc chung dùng được cho mọi chatbot: dán đúng đoạn cần, bỏ chữ ký và phần trích lại thư cũ, mở chat mới khi đổi việc, sửa tin gốc khi AI hiểu sai, nói rõ độ dài câu trả lời, và chọn mô hình hợp việc. Giới hạn và cách tính cụ thể của từng dịch vụ khác nhau, nên hãy xem trang hướng dẫn của dịch vụ bạn dùng.
Đính kèm file có tốn hạn mức không? Tuỳ ứng dụng. Có nơi đưa nguyên nội dung file vào cuộc trò chuyện, khi đó file tốn như chữ bạn dán. Trên LOSAN, file đính kèm nằm riêng và AI chỉ đọc phần cần cho câu hỏi, nên đính kèm thường đỡ tốn hơn dán. Ở đâu thì cách giảm vẫn là hỏi theo từng chương hoặc mục, và dùng Project nếu có sẵn một bộ tài liệu cố định.
Xem thêm
- Video gốc: Token trong AI là gì? 7 cách tiết kiệm token
- Vì sao chat với AI càng lâu càng trả lời kém
- Mở chat mới mà không mất gì: mẫu bản bàn giao
- Đưa càng nhiều tài liệu AI trả lời càng tệ
- Vì sao ChatGPT quên nội dung khi dán tài liệu dài
- Bảo AI trả lời đúng định dạng, bảng, độ dài
- AI trả lời chưa ưng thì sửa thế nào
Muốn thử cách hỏi gọn này trên một đề tài thật thì mở LOSAN và bắt đầu một cuộc trò chuyện mới. Đăng ký kênh YouTube LOSAN AI để xem các video tiếp theo trong chuỗi "Dùng AI chat như người làm nghề".
Bài viết cập nhật 14/11/2026. Số token do chúng tôi tự đếm bằng o200k_base ngày 14/11/2026; mỗi mô hình có bộ tách riêng nên số sẽ khác. Email, công ty và tài liệu trong ví dụ là tự dựng, công ty giả định. Hạn mức và cách tính của các dịch vụ AI thay đổi theo thời gian; xem trang giá hiện hành của dịch vụ bạn dùng.